DINO-WM:我的世界模型入门笔记
从预训练视觉特征到动作规划,尽量不借助数学公式,读懂 DINO-WM 的思路与方法。
DINO-WM: My first notes on world models
From pretrained visual features to action planning: making sense of DINO-WM, with as little math as possible.
这篇paper算是我学习世界模型的起点了,ok 开干!
(先叠个甲,很多内容是读到了就随性写下,正确性不做担保。本文的目的是尽量不涉及数学公式的前提下,把dino-wm的思路和方法讲清楚)
DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning, ICML 2025
世界模型应该做到什么
作者开头就写出了,他们认为一个真正的世界模型应该是什么样子:
- 能够基于离线预收集的轨迹进行训练(感觉是最基础的,不必多说)
- 支持测试时的行为优化(在线优化)
- 促进任务无关的推理(泛化性)
作者为了满足以上要求,提出了一种无需重建视觉世界即可建模视觉动态的新方法(好绕啊)。
把三条要求拆开看
我们来一条条拆开说明:
首先是第一条"1) 能够基于离线预收集的轨迹进行训练",作者文章中说是利用dinov2预训练的空间Patch特征,使其能够通过预测未来Patch特征从离线行为轨迹中学习。(把dinov2看作一个预训练的视觉编码器)
接着是第二条"2) 支持测试时的行为优化",文章中说测试期间使用模型预测控制与推理时最优化来达成目标,而无需任何额外信息。感觉就是在测试时固定世界模型参数,只优化动作序列。
最后是第三条"3)促进任务无关的推理"作者在6个环境上进行了zero-shot评估,涵盖非常全面,完全可以支撑这个论点。
DINO-WM 的建模流程
作者接着在文章中定义了什么是世界模型,简单来说世界模型就是:
现在看到什么 + 做什么动作 → 接下来世界会变成什么样
文章中dino-wm具体是这样做的:
- 图片送入dinov2变为潜在特征(Observation model)
- 将历史特征和动作相结合预测未来的特征(Transition model)
- 把未来特征变为RGB 图片(Decoder model),这一步用于可视化,不是必须的。
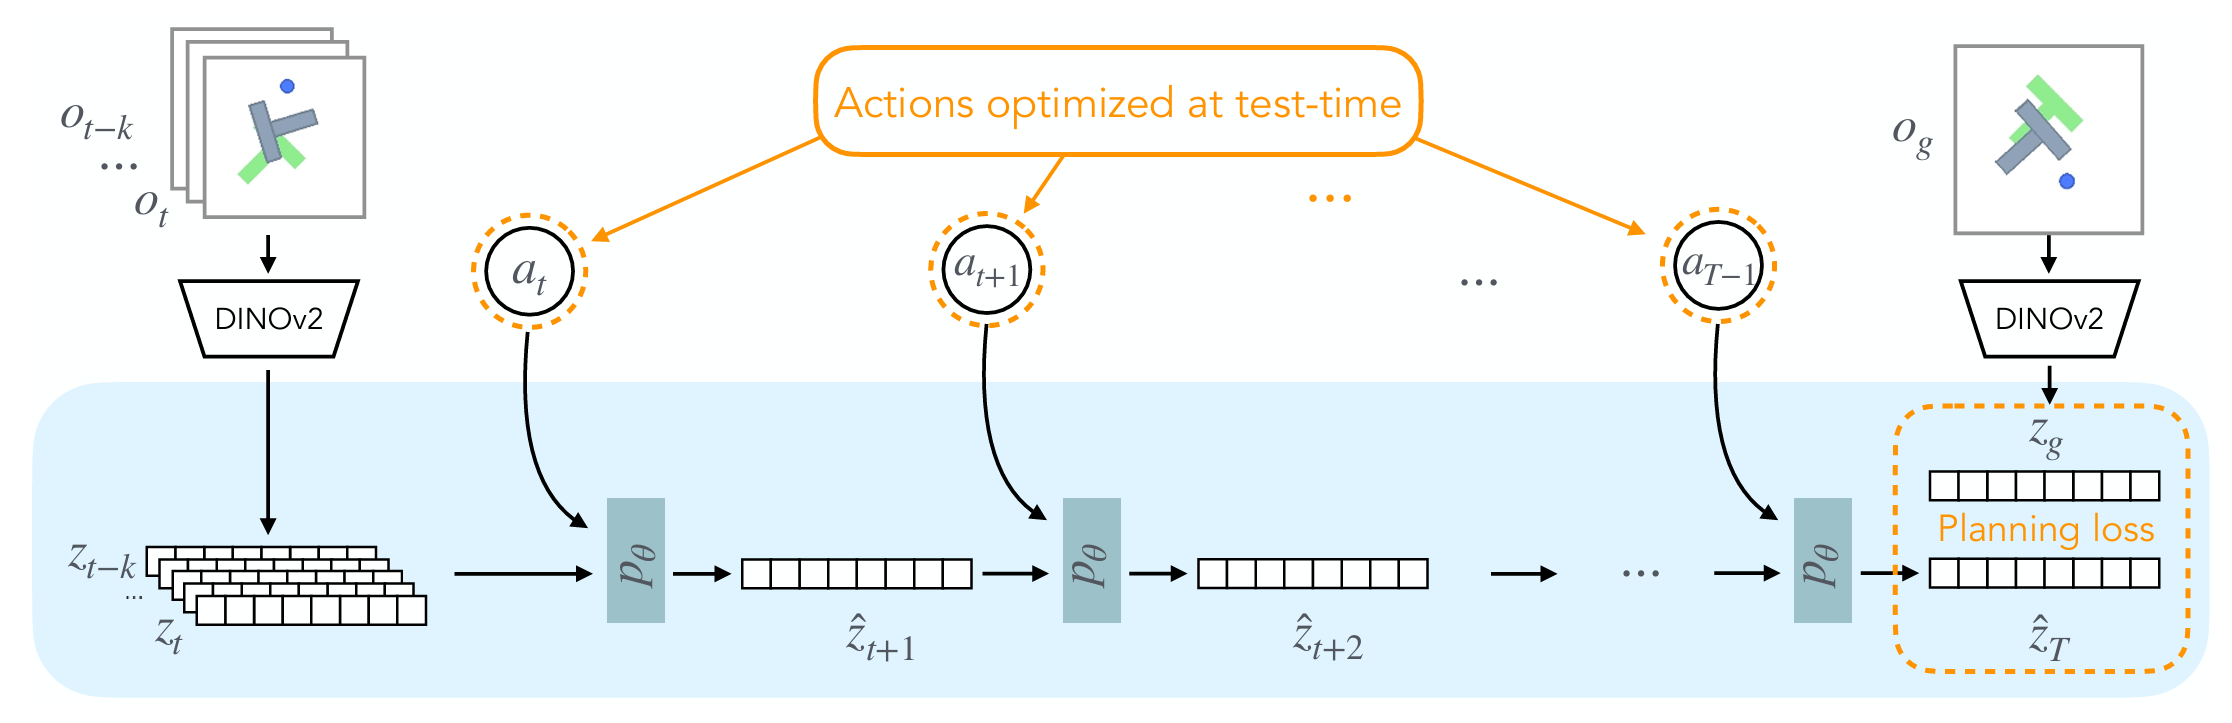
上面是文章的方法图,左边和右边是dinov2为模型提供任务无关的状态表征。中间是Transition model使用vit架构,采用帧级注意力(当前帧只能读取过去帧,整帧所有 Patch 一起预测。其实llm也是这样,预测token时能看到之前的所有token)
动作经过MLP编码后拼接到每个Patch特征中,使模型能够学习动作如何改变环境。训练是直接最小化预测dinov2特征与真实下一帧dinov2特征的MSE损失。
如何搜索动作序列
在动作方面,作者使用MPC(Model Predictive Control模型预测控制)结合CEM(Cross-Entropy Method交叉熵方法)反复搜索动作序列,使预测最终状态尽可能接近目标状态。坦白来讲,交叉熵我是知道的,mpc让我想起来了去年火过一段时间的大模型mpc接口...
不扯了,这部分我感觉是一种最优搜索方法,有点抽象。在附录中作者说CEM是从分布中采样一组动作序列,初始分布设置为高斯分布,看起来是一种随机采样方法。
然后对每个采样的动作序列预测潜在空间中的结果轨迹,选择成本最低的前几个动作序列,并相应地更新分布的均值和协方差。一直这样更新循环直到满足条件或者达到迭代次数的阈值。
This paper marks the start of my journey into world models. Okay, let's get into it!
A quick disclaimer: much of this was written spontaneously as I read, so I can't guarantee that everything is correct. My aim is to explain the ideas and methods behind DINO-WM with as little math as possible.
DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning, ICML 2025
What should a world model be able to do?
The authors begin by laying out what they believe a real world model should be able to do:
- Train on trajectories collected offline. This feels like the most basic requirement, so there isn't much to add.
- Support action optimization at test time, i.e., online optimization.
- Enable task-agnostic reasoning, i.e., generalization.
To meet these requirements, they propose a new way to model visual dynamics without reconstructing the visual world. Quite a mouthful!
Unpacking the three requirements
Let's go through them one by one.
First, training on trajectories collected offline. The paper uses spatial patch features from a pretrained DINOv2 model to learn from offline action trajectories by predicting future patch features. Think of DINOv2 as a pretrained visual encoder.
Second, supporting action optimization at test time. The paper says it uses model predictive control and inference-time optimization to reach a goal without any extra information. My understanding is that the world model's parameters stay fixed during testing, and only the action sequence is optimized.
Finally, enabling task-agnostic reasoning. The authors conduct zero-shot evaluations in six environments. The coverage is very broad, and I think it supports this claim well.
How DINO-WM works
The authors then define what a world model is. Put simply:
What I see now + the action I take → what the world will look like next.
Here is how DINO-WM does this:
- Feed an image into DINOv2 to obtain latent features — the observation model.
- Combine past features with actions to predict future features — the transition model.
- Turn future features into RGB images — the decoder model. This step is for visualization and is not required.
The figure above shows the method. On the left and right, DINOv2 provides task-agnostic state representations. In the middle, the transition model uses a Vision Transformer (ViT) architecture with frame-level attention: the current frame can only read past frames, and all patches in a frame are predicted together. In a sense, large language models do something similar — when predicting a token, they can see all the preceding tokens.
Actions are encoded by a multilayer perceptron (MLP) and concatenated with each patch feature, allowing the model to learn how actions change the environment. Training directly minimizes the mean squared error (MSE) between the predicted DINOv2 features and the actual DINOv2 features of the next frame.
Searching for an action sequence
For actions, the authors combine model predictive control (MPC) with the cross-entropy method (CEM), repeatedly searching for action sequences so that the predicted final state is as close to the goal state as possible. To be honest, I know cross-entropy, but “MPC” reminds me of those “MPC” interfaces for large language models that were popular for a while last year…
Anyway, this part feels like an optimal-search method to me, and it is a little abstract. In the appendix, the authors explain that CEM samples a set of action sequences from a distribution, initially a Gaussian. So it looks like a random-sampling method.
For each sampled action sequence, the model then predicts the resulting trajectory in latent space. The lowest-cost sequences are selected, and the distribution's mean and covariance are updated accordingly. This loop continues until the stopping condition is met or the iteration limit is reached.